Så fik jeg et lille bitte stykke SkyNet op og kører lokalt på en laptop med hjælp fra @djarner på dagens @cryptohagen.
-
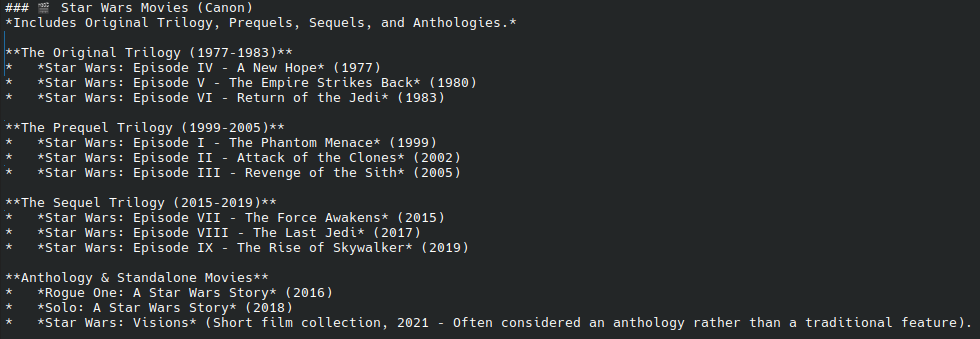
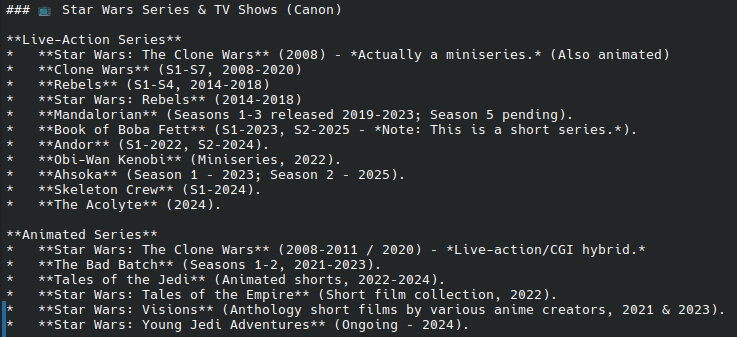
Så går jagten ind på en model der kan læse tekst i billeder. Modellen granite3.2-vision levere en udmærket fortolkning af teksten på billede, men jeg er ude efter en model der bare levere teksten.
Modellen minicpm-v4.6 (en letvægts model på 1.5 GB) klarer det fint med prompten "Open picture /home/user/test.jpg and read the text in the picture. Only text."

 ️️ Den kører rimelig hurtig i CPU mode.
-
@alf149 Jeg må spørger ham til næste Cryptohagen. Indtil da prøver jeg nogle forskellige modeller af. Download fra ollama.com er meget langsom, så det tager sin tid.
@alf149 Fx denne model ... https://social.data.coop/@tbhdk/117207064220976304
-
Modellen minicpm-v4.6 (en letvægts model på 1.5 GB) klarer det fint med prompten "Open picture /home/user/test.jpg and read the text in the picture. Only text."
️️ Den kører rimelig hurtig i CPU mode.Min download af nye modeller med kommandoen ollama run [model navn] har været utrolig langsom og med flere tilbage spring for at download en blok igen. Det viser sig at det er min ProtonVPN, som laver problemer sammen med ollama.com. Så min anbefaling er at slå VPN fra ved download af model og slå VPN til ved brug af model.
-
Min download af nye modeller med kommandoen ollama run [model navn] har været utrolig langsom og med flere tilbage spring for at download en blok igen. Det viser sig at det er min ProtonVPN, som laver problemer sammen med ollama.com. Så min anbefaling er at slå VPN fra ved download af model og slå VPN til ved brug af model.
Modellen nemotron3 kan lidt mere end Qwen og Hermes3. Den fylder så også 27 GB. Den kører dog lidt langsommere. Formentlig fordi den udover min GPU's 12 GB RAM må benytte en del af min maskines 64 GB (almindelig) RAM.
 https://ollama.com/library/nemotron3
 Which actors have played Doctor Who? Order of Doctor Who regenerations.

-
#!/usr/bin/env bash
echo Skriv dansk tekst:
echo
read dktext
echoecho Translate from da-DK to en-GB: > input.txt
echo >> input.txt
echo $dktext >> input.txtollama run translategemma:4b < input.txt > output.txt
echo Engelsk oversættelse:
echo
cat output.txtrm input.txt
rm output.txt@tbhdk
Har du prøvet fabric? -
@tbhdk
Har du prøvet fabric?@notsoloud Ikke endnu. Der er nogle varianter til Ollama, men om det er den samme som du mener det ved jeg så ikke.
-
@notsoloud Ikke endnu. Der er nogle varianter til Ollama, men om det er den samme som du mener det ved jeg så ikke.
@tbhdk
fabric er et CLI-program til at kalde modellerne -
@tbhdk
fabric er et CLI-program til at kalde modellerne@notsoloud Ah, sådan. Den må jeg kigge på ved lejlighed.
-
Modellen nemotron3 kan lidt mere end Qwen og Hermes3. Den fylder så også 27 GB. Den kører dog lidt langsommere. Formentlig fordi den udover min GPU's 12 GB RAM må benytte en del af min maskines 64 GB (almindelig) RAM.
https://ollama.com/library/nemotron3 Which actors have played Doctor Who? Order of Doctor Who regenerations. Hvor lang tid tog det svar?
Hvor lang tid ville det have taget at bruge en søgemaskine (der ikke er google) at finde det samme svar på en wiki?
Hvor meget ram havde søgningen brugt?
Hvor meget strøm har dit 12GB grafikkort brugt på at digte noget der tilfældigvis var rigtigt? -
Hvor lang tid tog det svar?
Hvor lang tid ville det have taget at bruge en søgemaskine (der ikke er google) at finde det samme svar på en wiki?
Hvor meget ram havde søgningen brugt?
Hvor meget strøm har dit 12GB grafikkort brugt på at digte noget der tilfældigvis var rigtigt?@oz1tmm Formålet er ikke at lave en sammenligning. Opgaverne er kun test opgaver, som jeg lige kunne finde på. Altså, opgaver som jeg kunne tjekke op imod fx Wikipedia. Mit primære mål var at finde en oversætter AI, som jeg kan bruge lokalt i stedet for at fodre Google Translate. Det har jeg fundet i translategemma, som er en åben model som bygger på Googles Gemma3. Uanset om vi kan lide Google eller ej, så har Google designet nogle okay produkter.
-
Modellen nemotron3 kan lidt mere end Qwen og Hermes3. Den fylder så også 27 GB. Den kører dog lidt langsommere. Formentlig fordi den udover min GPU's 12 GB RAM må benytte en del af min maskines 64 GB (almindelig) RAM.
https://ollama.com/library/nemotron3 Which actors have played Doctor Who? Order of Doctor Who regenerations. Opsummering omkring min lokalt hostet, åbne oversætter-AI (som i øjeblikket står på mit køkkenbord oven på min jump host, to brugte laptop).
-
Opsummering omkring min lokalt hostet, åbne oversætter-AI (som i øjeblikket står på mit køkkenbord oven på min jump host, to brugte laptop).
Sidste skud på stammen af AI's er llama4 på 67 GB, som helt sikkert presser min maskine til det yderste (12 GB RAM i GPU + 64 GB RAM på bundkort = 76 GB). llama4 kører som den skal og giver bedre svar end de andre, mindre modeller. Jeg har så som en del af llama4 også installeret Hermes Agent og knyttet en Matrix konto til den. Denne Matrix konto har adgang til et chatrum, hvor den kun kan chatte med min Matrix bruger.
llama4
https://ollama.com/library/llama4Hermes Agent
https://hermes-agent.org/ -
Sidste skud på stammen af AI's er llama4 på 67 GB, som helt sikkert presser min maskine til det yderste (12 GB RAM i GPU + 64 GB RAM på bundkort = 76 GB). llama4 kører som den skal og giver bedre svar end de andre, mindre modeller. Jeg har så som en del af llama4 også installeret Hermes Agent og knyttet en Matrix konto til den. Denne Matrix konto har adgang til et chatrum, hvor den kun kan chatte med min Matrix bruger.
llama4
https://ollama.com/library/llama4Hermes Agent
https://hermes-agent.org/Llama4 med Hermes Agent startes op i Ollama med denne kommando:
ollama launch hermes --model llama4
Der er med andre ord et kontrolpanel
og en Matrix gruppechat i denne AI model. Og jeg har helt sikkert brug for en introduktion til hvordan jeg bruger Hermes Agent før jeg fortsætter. Det bliver formentlig på næste Cryptohagen. -
Min download af nye modeller med kommandoen ollama run [model navn] har været utrolig langsom og med flere tilbage spring for at download en blok igen. Det viser sig at det er min ProtonVPN, som laver problemer sammen med ollama.com. Så min anbefaling er at slå VPN fra ved download af model og slå VPN til ved brug af model.
@tbhdk prøv evt at skifte host, det har jeg nogen gange oplevet hjælper på download "resultatet"
-
Llama4 med Hermes Agent startes op i Ollama med denne kommando:
ollama launch hermes --model llama4
Der er med andre ord et kontrolpanel
og en Matrix gruppechat i denne AI model. Og jeg har helt sikkert brug for en introduktion til hvordan jeg bruger Hermes Agent før jeg fortsætter. Det bliver formentlig på næste Cryptohagen.@tbhdk hermes er fremragende. Jeg har lavet en portable version hvis du har behov for at have den med på farten.
-
@tbhdk hermes er fremragende. Jeg har lavet en portable version hvis du har behov for at have den med på farten.
@kimschulz
Kan den også kører uden gpu?
Og fortæl gerne, selvom jeg ikke tror @tbhdk vil gå den vej. -
@kimschulz
Kan den også kører uden gpu?
Og fortæl gerne, selvom jeg ikke tror @tbhdk vil gå den vej.@alf149 @tbhdk hermes er jo bare et agent harness så den er tooling og modellen kan du kører hvor du vil.
https://github.com/kimusan/Hermes-Portable
Jeg har den på en USB og hvis jeg har brug for AI hjælp med noget på en af mine maskiner så sætter jeg den i og spinner en hermes op. Den har al min baghistorie med på usb og connecter til enten en af mine egne modeller eller en en kommerciel remote model. Men den kender mig for alt det er med på usb så det gør det lettere - ikke noget med role play el. Introduktion -
@alf149 @tbhdk hermes er jo bare et agent harness så den er tooling og modellen kan du kører hvor du vil.
https://github.com/kimusan/Hermes-Portable
Jeg har den på en USB og hvis jeg har brug for AI hjælp med noget på en af mine maskiner så sætter jeg den i og spinner en hermes op. Den har al min baghistorie med på usb og connecter til enten en af mine egne modeller eller en en kommerciel remote model. Men den kender mig for alt det er med på usb så det gør det lettere - ikke noget med role play el. Introduktion@kimschulz @tbhdk
Så ved jeg hvad denne eftermiddag skal gå med. 🤩 -
Llama4 med Hermes Agent startes op i Ollama med denne kommando:
ollama launch hermes --model llama4
Der er med andre ord et kontrolpanel
og en Matrix gruppechat i denne AI model. Og jeg har helt sikkert brug for en introduktion til hvordan jeg bruger Hermes Agent før jeg fortsætter. Det bliver formentlig på næste Cryptohagen.Llama4 - Facebooks samling af AI-modeller - spiser sommetider svampe, stærke svampe
 Fx i dette eksempel.
Llama4: "Meta's latest collection of multimodal models."
-
Llama4 - Facebooks samling af AI-modeller - spiser sommetider svampe, stærke svampe
Fx i dette eksempel.Llama4: "Meta's latest collection of multimodal models."
Hvis du vil prøve Hermes Agent, en samling af AI modeller, på en USB nøgle, så besøg @kimschulz GitHub om hvordan dette gøres